AI 图像生成器在线使用
通过文本生成图像 AI 模型,轻松在线创作高质量 AI 图像作品。
探索所有 23 款 AI 图片生成模型
从多款 AI 图片模型中挑选最适合你创作需求的工具,涵盖文生图、图生图、局部重绘等多种能力。
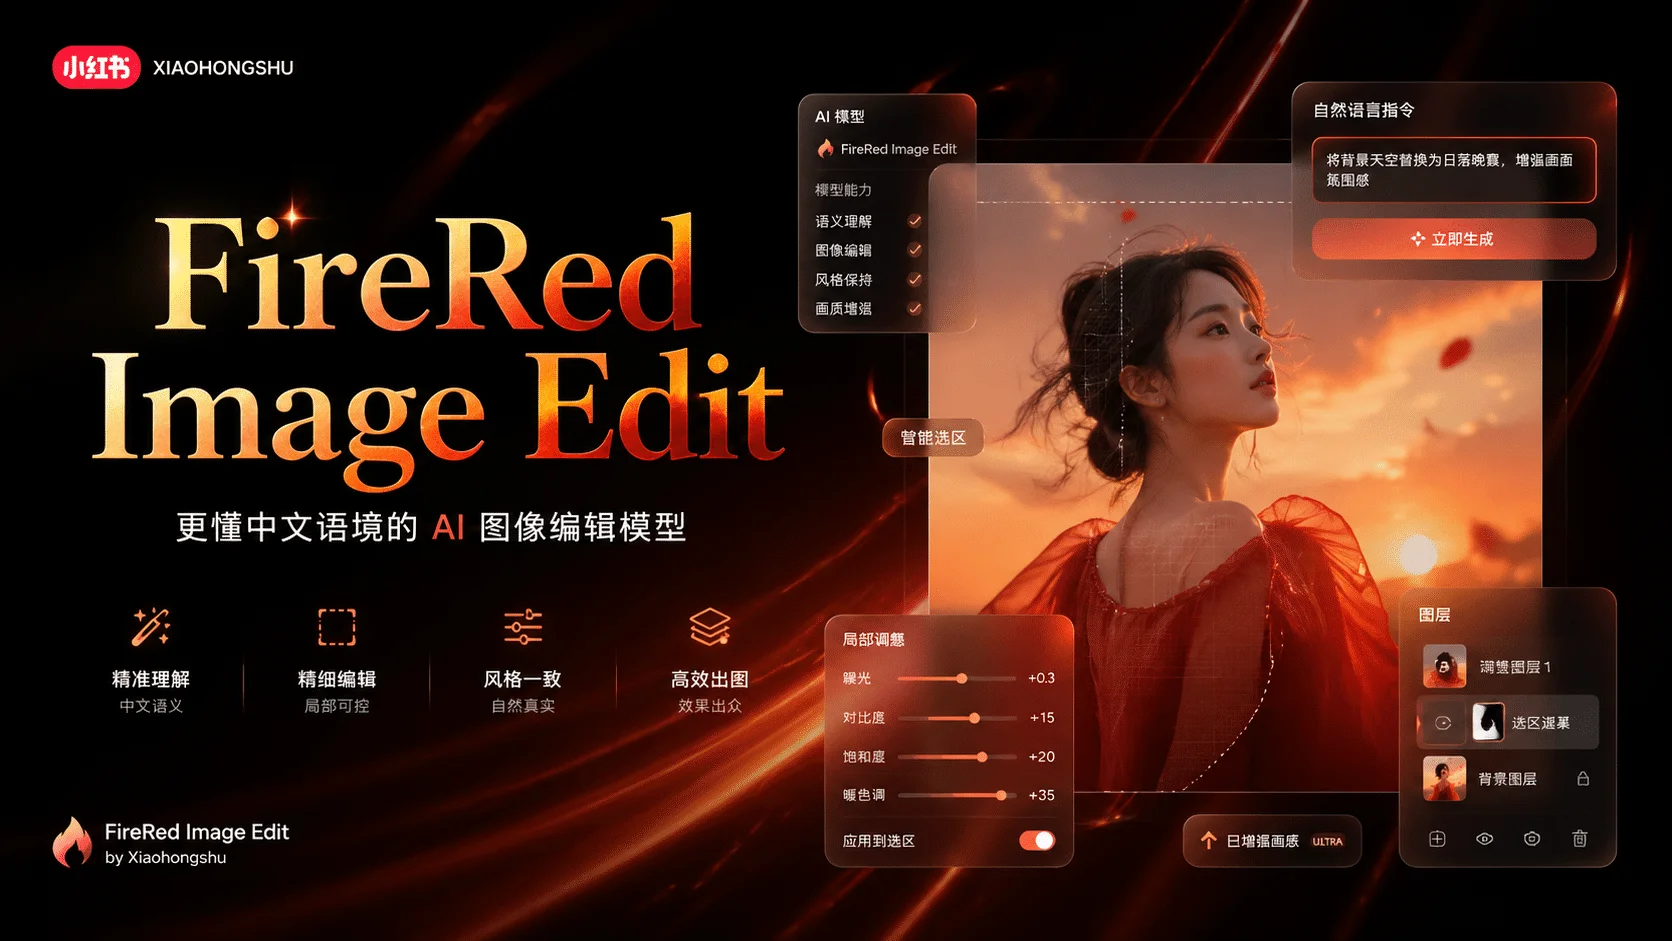
FireRed Image Edit
专注于局部重绘、物体替换、背景修改与风格细化的 AI 图片编辑模型。适合在保留原图主体结构的前提下,快速完成高质量可控编辑,尤其适用于电商修图、海报改图、社媒素材优化和创意二次加工。
Grok 4.2 Image
xAI 最新的 Grok 4.2 图像生成模型,擅长创意构图与风格化表达,支持文生图和图生图,在人物肖像、场景渲染和艺术创作方面表现出色。
FLUX.2 Klein 9B
黑森林实验室推出的超速轻量图像生成模型,9B参数量实现极快出图速度,适合高频批量生成和快速迭代场景。
Nano Banana
基于 Google 技术的图像生成模型,细节渲染出色,支持多图参考。最多可上传14张参考图片,精准控制风格,支持多种宽高比。
GLM Image
智谱AI的文生图模型,中英文双语理解能力强。生成速度快、成本极低,适合快速内容创作和批量工作流。
Nano Banana 2
基于 Google Gemini Flash Image 的快速、实惠图像生成模型,支持0.5K至4K分辨率,适合日常高频创作。
Nano Banana 2.1
Google 高效的 Gemini 图像模型,画面文字渲染更精准,多轮连续编辑时的角色与风格更一致。支持 1K、2K、4K 输出,最多可用 10 张参考图。
Nano Banana 2 Lite
Google DeepMind 速度最快、效率最高的 Gemini Image 模型,适合低延迟图像生成与编辑。适用于快速草稿、参考图改图和轻量成本下的 1K 视觉探索。
Nano Banana Pro
面向高保真、高细节、对构图与人物/物体一致性要求很高的专业生成模型。
Seedream 5.0 Lite
字节跳动新一代轻量级图像生成模型,在保持旗舰级视觉质量的同时大幅提升生成速度。支持最多15张批量生成,提示词理解能力强,适合高频创作场景。

Seedream 5.0 Flash
快速生成与编辑图像,支持最多 10 张参考图及 1K、1.5K、2K 输出。
Seedream 5.0 Pro
字节跳动高质量 Seedream 5.0 Pro 图像模型,强化复杂提示词理解、细节表现与构图稳定性,适合对商业视觉品质要求较高的生成与编辑任务。
GPT-Image 1.5
专业级真实感图像生成模型,擅长捕捉细腻的光影质感与自然的人物表情。支持文生图和图生图两种模式,在保真度和细节还原上表现出色,特别适合需要高度真实感的商业场景。
GPT Image 2
支持最多16张参考图的多图参考图像生成模型,适合需要高一致性、强可控性和复杂需求表达的商业创作。支持文生图与图生图,适用于电商主图、角色设定、品牌海报和多图融合场景。
GPT Image 2.5
OpenAI GPT Image 2.5 Flare 模型,进一步提升细节清晰度、参考图一致性和局部改图能力。支持文生图与图生图,最多可上传16张参考图。
GPT Image 2.5 Flare
OpenAI GPT Image 2.5 Flare 模型,进一步提升细节清晰度、参考图一致性和局部改图能力。支持文生图与图生图,最多可上传16张参考图。
GPT Image 2.5 Sunburst
OpenAI GPT Image 2.5 Flare 模型,进一步提升细节清晰度、参考图一致性和局部改图能力。支持文生图与图生图,最多可上传16张参考图。
Seedream 4.5
旗舰级视觉生成模型,拥有极致的自然语言理解力与光影表现力。它不再依赖机械的标签堆砌,而是能听懂‘故事’与‘氛围’,在超写实摄影与超现实艺术间自由切换。
FLUX.2
次世代工业级模型,突破了 AI 绘图的“文字魔咒”。它拥有目前最强的指令遵循能力,不仅能完美生成图片内的指定单词/文本,还能精确控制复杂的人体手部动作与物体空间关系。
FLUX 3 Klein
Z-Image
专为文本到图像场景优化的模型,致力于把复杂描述准确映射为视觉元素,尤其擅长概念化与抽象描述还原。
Grok Imagine Image 2
xAI 新一代 Grok Imagine 图像模型,擅长创意构图、风格化视觉与高质量图像生成,适用于人物肖像、场景设计、广告素材和社交媒体内容。
Qwen Image 3
阿里 Qwen 新一代图像模型,强化复杂提示词理解、文字渲染与构图控制,适合海报、电商、创意设计和商业视觉等高质量图像生成场景。
常见问题
关于FireRed Image Edit的常见问题
由小红书智能创作核心技术团队开发的通用图像编辑模型,基于 Diffusion Transformer 架构,使用 Qwen2.5-VL 作为视觉语言编码器。
10+ 类别:物体添加/删除/替换、属性调整、背景编辑、风格迁移、文字编辑、照片修复、多图编辑、虚拟试穿、人像妆容、多元素融合。
30GB 显存,经过优化推理(蒸馏 + 量化 + 静态编译),每张图约 4.5 秒。
开源 SOTA:ImgEdit (4.56)、GEdit EN (7.943)、GEdit CN (7.887)、REDEdit EN (4.26)、REDEdit CN (4.33),超越部分闭源模型。
是的,原生支持中文和英文编辑指令。
自动多图处理流程:ROI 检测 → 裁剪拼接 → 重新描述。原生支持 1-3 张输入图像,3 张以上通过 Agent 处理。
可以,已开源完整的 LoRA 训练代码。同时提供 LoRA Zoo,包含预训练风格(妆容、Covercraft 文字风格等)。
Apache 2.0,完全开源。可在 HuggingFace、ModelScope 和 GitHub 上获取。
用户反馈
研究者与创作者对FireRed Image Edit的评价
“FireRed的指令跟随能力在开源模型中处于领先水平,物体编辑和背景替换的效果令人惊喜。”
陈思雨: “FireRed的指令跟随能力在开源模型中处于领先水平,物体编辑和背景替换的效果令人惊喜。”
李明轩: “文字渲染功能非常实用,中英文都能精准渲染,字体样式保持得很好,做海报设计效率翻倍。”
王芳: “老照片修复效果超出预期,划痕去除和色彩还原都很自然,帮我修复了很多珍贵的家庭照片。”
张伟: “虚拟试穿功能太好用了,多图编辑灵活度高,做电商内容再也不用反复拍摄了。”
刘洋: “v1.1的身份一致性增强效果显著,面部特征在多次编辑后依然保持稳定,学术价值很高。”
赵雪: “全面人像妆容功能从专业美颜到创意妆容都有覆盖,数十种风格一键切换,内容产出效率大幅提升。”
孙浩: “多元素融合能力很强,Agent驱动的自动裁剪拼接支持10+元素组合,创意合成变得简单高效。”
周琳: “开源模型部署方便,Lightning版本8步推理速度很快,30GB显存就能跑,集成到产品中非常顺畅。”