动态运镜
点击播放
动态运镜效果
跟踪镜头、环绕镜头、快速转场,AI 自动规划运镜路线,画面流畅不抖动,出片即有电影感。
使用 AI 模型 generate 视频,支持文本到视频、图片到视频和视频到视频。
不用猜效果好不好,直接看实拍。这些视频全部由 AI 生成,展示了运镜、动作、特效和音频卡点的真实表现。
快速打斗、极限运动、复杂交互——AI 能精准捕捉动作节奏和物理细节,生成连贯、逼真、有冲击力的画面。
跟踪镜头、环绕镜头、快速转场,AI 自动规划运镜路线,画面流畅不抖动,出片即有电影感。
人物跑跳、物体碰撞、环境交互,动作逻辑全程保持一致,不会出现穿模或违和感。
传视频学运镜、传音频卡节拍、传图片定风格。AI 理解你的参考素材,生成更贴合预期的视频。
上传一段参考视频,AI 学习镜头调度和动作逻辑,生成风格一致的新视频,团队协作更高效。
甩镜、匹配剪辑、风格化揭示——AI 学习转场节奏,批量生成有剪辑感的视频片段。
把脑海里的画面描述出来,AI 自动串联场景、补全动作和叙事节奏,从想法到成片最快几分钟。
上传音乐,AI 根据节拍控制画面切换和动作节奏,做抖音卡点视频、广告节奏片再也不用手动对。
从多款 AI 视频模型中选择,支持文生视频、图生视频、视频转视频等多种生成模式。
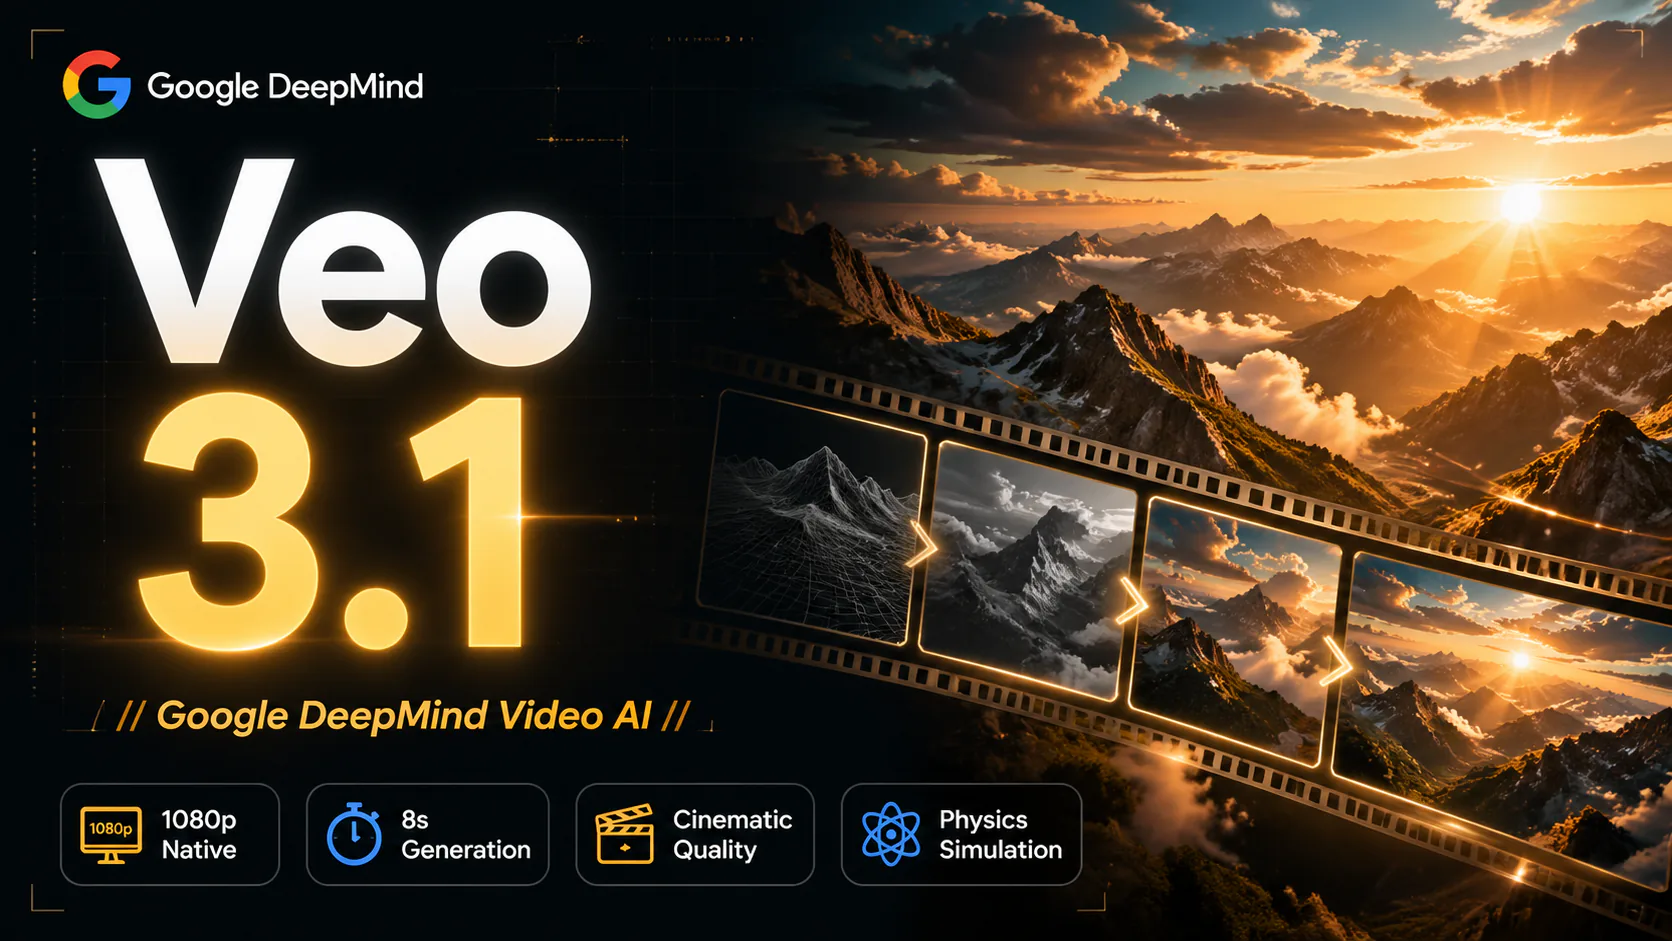
Google 最新旗舰视频生成模型。Veo 3.1 Quality 拥有业界顶尖的光影物理引擎和超高保真度,能完美还原现实世界的纹理、动态与细节。支持 16:9、9:16 和自动宽高比,适合商业级高质量视频制作。
Sora 系列的标准版本。在保持 OpenAI 优秀的语义理解能力的同时,优化了生成速度与成本。非常适合快速验证分镜脚本、社交媒体短视频制作及通用创意生成。
HappyHorse 是阿里巴巴下一代多模态视频生成模型,原生支持音视频协同生成。单一模型覆盖四种场景——文生视频、图生视频、多图参考生视频、视频原位编辑,非常适合广告、电商、短剧和社媒创意内容。
Wan 2.6 是一款先进的视频生成模型,支持文本生成视频、图片生成视频和视频转视频三种模式。提供 5秒、10秒、15秒 的时长选项和 720p、1080p 两种分辨率,支持多镜头切换功能,适合创作多样化的视频内容。


Kling 动作控制模型,通过上传参考图片和视频,精准控制角色的动作和姿态。支持3-30秒视频,可生成与参考一致的角色动作,适合角色动画和动作迁移场景。
以惊人的动作一致性和物理规律捕捉著称。Kling 2.6 擅长生成大幅度的人物动作、复杂的物体交互以及电影级的运镜效果,画面细腻且连贯。
字节跳动先进的视频生成模型。Seedance 1.5 Pro 擅长角色动画,具有精准的口型同步和自然的表情。拥有逼真的运动物理效果,支持多种视频比例(1:1、21:9、4:3、3:4、16:9、9:16),提供灵活的时长选项(4秒、8秒、12秒),并可选择生成音频。
字节跳动新一代视频生成模型。Seedance 2 强调高质量画面、复杂运动表现与多模态参考控制,支持文本、图片、视频与音频输入,适合需要更高一致性与更强镜头表达的专业视频创作。
Wan 3.0 Video 是阿里巴巴的多模态视频生成模型,支持文生视频、图生视频、参考生视频,以及使用图片、视频和音频参考进行视频编辑。
Wan 3.0 Video Prime 是更高保真的 Wan 版本,适合对画面细节、动作控制和构图一致性要求更高的文生、图生和参考生视频项目。
字节跳动的新一代视频生成模型,支持文生视频、首尾帧图生视频和多模态参考生视频。支持图片、视频、音频参考,提供 480p/720p、4–30 秒时长和可选音频生成。
Seedance 2 的高速版本,兼顾速度与成本效率。适合快速迭代创意、批量测试提示词与高频内容生产,同时保留对图片、视频与音频参考的支持。
Seedance 2 的轻量低成本版本。支持首尾帧与多模态参考,单秒积分更低,适合草稿、社交短视频与大批量试跑。
xAI 推出的创意视频生成模型。Grok Imagine 擅长将文本描述转化为富有想象力的视频内容,支持多种宽高比(2:3、3:2、1:1、9:16、16:9),提供 fun、normal、spicy 三种风格模式,适合创意内容制作和快速原型验证。
Grok Imagine Video 1.5 Preview is an image-to-video model. It requires one reference image, outputs fixed 720P video, supports 5-15 second durations, and supports 16:9, 9:16, 3:2, 2:3, 1:1, 3:4 and 4:3 aspect ratios.
Gemini Omni 是 Google 基于 Omni-Flash-Ext 的高级视频生成模型。支持文生视频、单图生视频和3张参考图融合。支持 4/6/8/10 秒时长,提供 16:9 和 9:16 宽高比。
Gemini Omni 1.1 Flash 是 Google 的多模态视频生成模型,支持文生视频、图生视频和参考图片,提供灵活时长与多种宽高比。
MiniMax H3 是多模态视频生成模型,支持文生视频、图生视频和参考生视频,提供 768p/2K 输出、灵活时长与参考音频。
MiniMax H3 Max 是高速视频生成模型,支持 480p/768p 文生视频、首尾帧图生视频,以及图片、视频、音频多模态参考生视频,输出时长 5 至 15 秒。
MiniMax H3 Max Turbo 是更低成本的极速档,支持 480p/768p 文生视频,以及首帧必填、尾帧可选的图生视频。
将文字或单张图片生成 1–15 秒视频,最高支持 1080p,可选同步生成音频。
PixVerse V6 是一款灵活的视频生成模型,支持文生视频、图生视频、首尾帧转场和视频续写。支持 360p 至 1080p、1 至 15 秒视频,以及可选的原生音频。
让一张首帧图动起来,或用最多15张参考图生成视频。支持540p至4K,单图模式3至16秒、参考模式1至16秒,可选同步音频。参考音频须为3至12秒的MP3。
输入文字、图片或参考视频,AI 自动生成高质量视频。不需要剪辑经验,不需要昂贵设备,几分钟出片。
输入一段描述或上传一张图片,AI 直接生成视频。从广告素材到社媒内容,一个平台全部搞定。
运镜、转场、节奏控制,AI 自动处理。你只管描述想要的效果,专业级画面质感交给它。
自动串联多个场景,生成有剧情、有节奏的完整短片。品牌故事、产品介绍、创意分镜,直接出片。
上传一段音乐,AI 自动对齐节拍和画面切换。做抖音爆款、广告节奏片、音乐 MV 都超省心。
随时随地打开浏览器就能生成视频,手机、平板、电脑全适配,碎片时间也能高效出片。
传图片定风格、传视频定运镜、传音频定节奏。参考什么就出什么,减少反复修改的痛苦。
关于FireRed Image Edit的常见问题
由小红书智能创作核心技术团队开发的通用图像编辑模型,基于 Diffusion Transformer 架构,使用 Qwen2.5-VL 作为视觉语言编码器。
10+ 类别:物体添加/删除/替换、属性调整、背景编辑、风格迁移、文字编辑、照片修复、多图编辑、虚拟试穿、人像妆容、多元素融合。
30GB 显存,经过优化推理(蒸馏 + 量化 + 静态编译),每张图约 4.5 秒。
开源 SOTA:ImgEdit (4.56)、GEdit EN (7.943)、GEdit CN (7.887)、REDEdit EN (4.26)、REDEdit CN (4.33),超越部分闭源模型。
是的,原生支持中文和英文编辑指令。
自动多图处理流程:ROI 检测 → 裁剪拼接 → 重新描述。原生支持 1-3 张输入图像,3 张以上通过 Agent 处理。
可以,已开源完整的 LoRA 训练代码。同时提供 LoRA Zoo,包含预训练风格(妆容、Covercraft 文字风格等)。
Apache 2.0,完全开源。可在 HuggingFace、ModelScope 和 GitHub 上获取。
研究者与创作者对FireRed Image Edit的评价
“FireRed的指令跟随能力在开源模型中处于领先水平,物体编辑和背景替换的效果令人惊喜。”
陈思雨: “FireRed的指令跟随能力在开源模型中处于领先水平,物体编辑和背景替换的效果令人惊喜。”
李明轩: “文字渲染功能非常实用,中英文都能精准渲染,字体样式保持得很好,做海报设计效率翻倍。”
王芳: “老照片修复效果超出预期,划痕去除和色彩还原都很自然,帮我修复了很多珍贵的家庭照片。”
张伟: “虚拟试穿功能太好用了,多图编辑灵活度高,做电商内容再也不用反复拍摄了。”
刘洋: “v1.1的身份一致性增强效果显著,面部特征在多次编辑后依然保持稳定,学术价值很高。”
赵雪: “全面人像妆容功能从专业美颜到创意妆容都有覆盖,数十种风格一键切换,内容产出效率大幅提升。”
孙浩: “多元素融合能力很强,Agent驱动的自动裁剪拼接支持10+元素组合,创意合成变得简单高效。”
周琳: “开源模型部署方便,Lightning版本8步推理速度很快,30GB显存就能跑,集成到产品中非常顺畅。”