AI画像生成
AIモデルで画像を生成し、テキストから画像、画像から画像をサポートします。
探索所有 23 款 AI 图片生成模型
从多款 AI 图片模型中挑选最适合你创作需求的工具,涵盖文生图、图生图、局部重绘等多种能力。
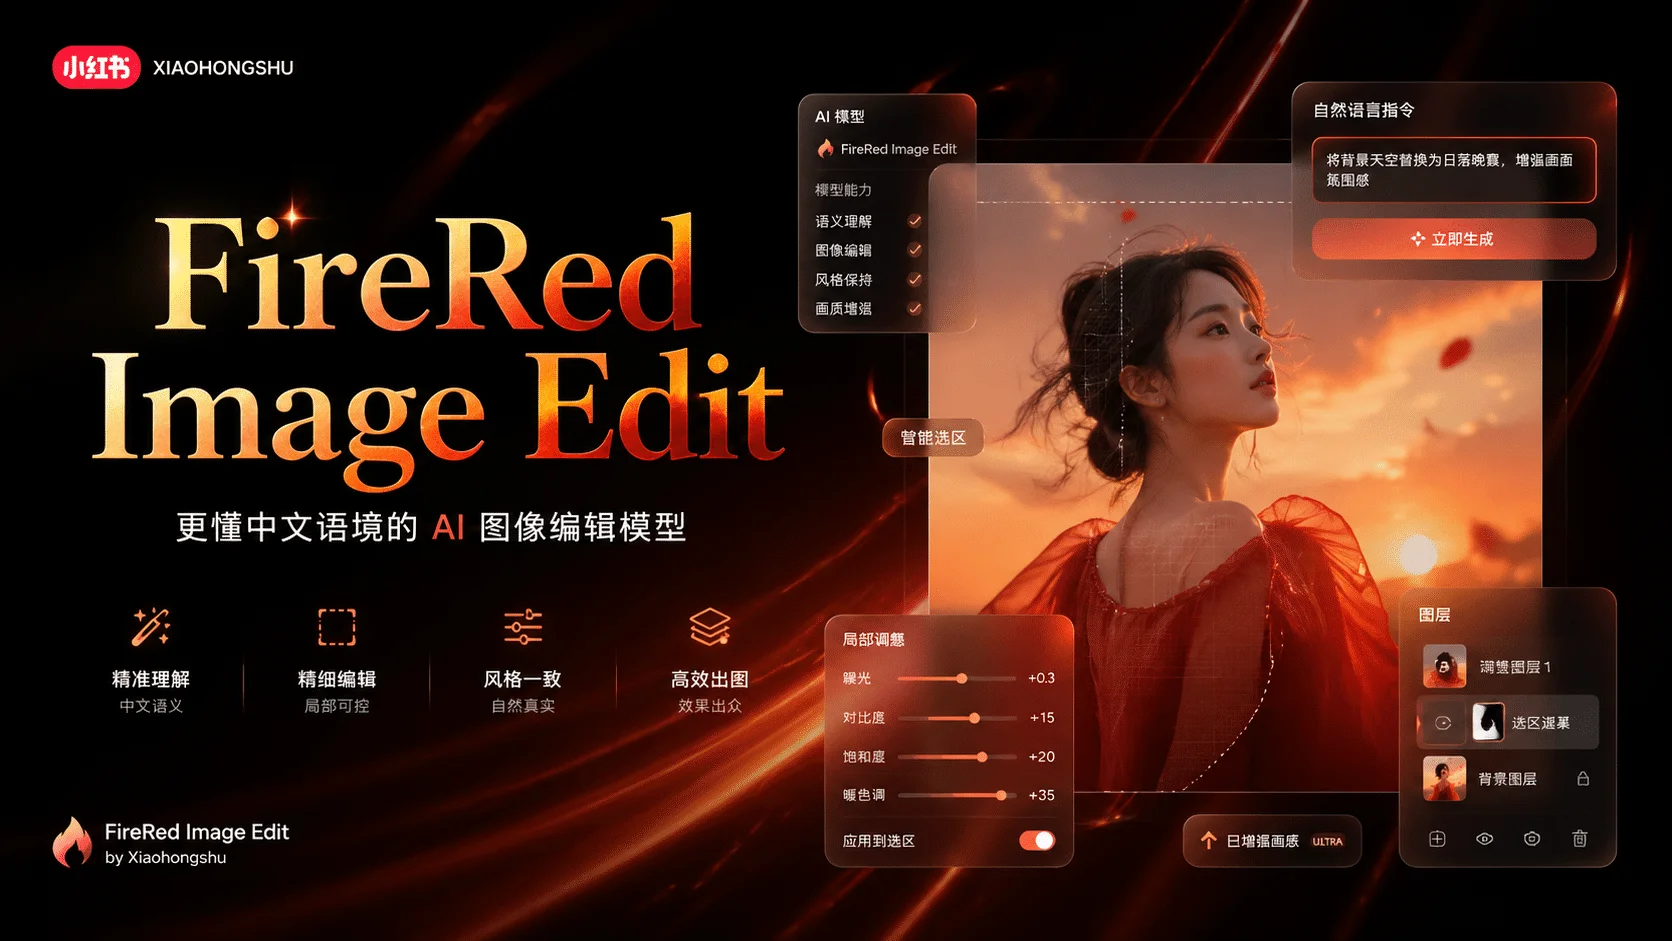
FireRed Image Edit
部分的な再描画、オブジェクト置換、背景変更、スタイル調整に特化した AI 画像編集モデルです。元画像の主要構図や被写体を保ちながら、高品質でコントロールしやすい編集を素早く行えるため、EC商品画像の修正、ポスター更新、SNS素材の最適化、クリエイティブな再加工に最適です。
Grok 4.2 Image
xAI の Grok 4.2 画像モデル。創造的な構図とスタイル表現に強く、テキスト生成・画像編集の両方で人物、シーン、アート制作に適しています。
FLUX.2 Klein 9B
Black Forest Labs の高速・軽量 9B 画像モデル。大量生成、ラフ作成、短い反復サイクルに適しています。
Nano Banana
速度優先の汎用画像生成モデル、品質と効率のバランスを取り、迅速な反復と日常の制作に適しています。
GLM Image
Zhipu AIのテキスト画像生成モデル。中国語・英語のバイリンガル理解に優れ、超低コストで高速生成。
Nano Banana 2
最大14枚の参照画像、Google検索、4K出力をサポートする次世代マルチモーダル画像生成モデル。最大20,000文字の超長プロンプトでより高い創作の柔軟性を提供します。
Nano Banana 2.1
Google の高効率な Gemini 画像モデル。画像内の文字描画がより正確になり、マルチターン編集でも人物とスタイルの一貫性が向上。1K・2K・4K 出力に対応し、参照画像は最大10枚まで使えます。
Nano Banana 2 Lite
Google DeepMind の最速かつ最も効率的な Gemini Image モデル。低レイテンシの画像生成と編集に向き、素早い下書き、参照画像編集、軽量なビジュアル探索に使えます。
Nano Banana Pro
高忠実度、高精細、構図と人物/物体の一貫性が求められるプロフェッショナルな生成モデル。
Seedream 5.0 Lite
次世代軽量画像生成モデル。強化されたセマンティック理解とフォトリアリスティックなレンダリングを備え、2Kおよび3K出力解像度での高速・高品質なテキストから画像への生成に最適化されています。

Seedream 5.0 Flash
最大10枚の参照画像を使った高速な画像生成・編集。1K、1.5K、2Kに対応。
Seedream 5.0 Pro
ByteDance の高品質画像モデル。複雑なプロンプト理解、細部表現、構図の安定性、商用品質のビジュアル生成に優れます。
GPT-Image 1.5
プロフェッショナルグレードの写実的な画像生成モデルで、繊細な光と影の質感と自然な人物の表情を捉えることに特化しています。テキストから画像、画像から画像の両方のモードをサポートし、忠実度とディテールの再現性に優れた性能を発揮し、特に高い写実性を必要とする商業シーンに適しています。
GPT Image 2
最大16枚の参照画像に対応したマルチリファレンス画像生成モデル。高い一貫性、強いコントロール性、複雑な商用ワークフロー向けに設計されており、テキストから画像・画像から画像の両方に対応します。
GPT Image 2.5
OpenAIのGPT Image 2.5 Flareは、ディテール、参照画像の忠実度、精密な編集を向上させたモデルです。最大16枚の参照画像を使ったテキストから画像・画像から画像に対応します。
GPT Image 2.5 Flare
OpenAIのGPT Image 2.5 Flareは、ディテール、参照画像の忠実度、精密な編集を向上させたモデルです。最大16枚の参照画像を使ったテキストから画像・画像から画像に対応します。
GPT Image 2.5 Sunburst
OpenAIのGPT Image 2.5 Flareは、ディテール、参照画像の忠実度、精密な編集を向上させたモデルです。最大16枚の参照画像を使ったテキストから画像・画像から画像に対応します。
Seedream 4.5
究極の自然言語理解力と光影表現力を備えたフラッグシップ視覚生成モデル。機械的なタグの羅列に頼るのではなく、「物語」や「雰囲気」を理解し、超写実的な写真と超現実的なアートの間を自由に切り替えます。
FLUX.2
AI描画の「テキストの呪縛」を打ち破る、次世代の産業グレードモデル。現在最強の指示遵守能力を持ち、画像内の指定された単語/テキストを完璧に生成するだけでなく、複雑な手の動きや物体の空間関係も正確に制御できます。
FLUX 3 Klein
Z-Image
テキストから画像へのシーンに最適化されたモデル、複雑な記述を視覚的要素に正確にマッピングすることに専念し、特に概念化と抽象的な記述の再現に優れています。
Grok Imagine Image 2
xAI の次世代 Grok Imagine 画像モデル。創造的な構図、スタイル表現、人物、シーン、広告、SNS 向け画像生成に適しています。
Qwen Image 3
Alibaba Qwen の次世代画像モデル。複雑なプロンプト理解、文字描画、構図制御、高品質ビジュアル生成を強化しています。
よくある質問
FireRed Image Editに関するよくある質問
FireRed Image Editは高品質な画像、ポスター、キャラクターデザイン、製品モックアップ、インフォグラフィックを生成できます。シーンの一貫性、ライティングシミュレーション、スタイル保持をサポート。
ネイティブ2K解像度、4Kアップスケーリング、インペインティング、キャラクター一貫性、テキストレンダリング、マルチスタイル切り替え、高忠実度出力。
柔軟な従量課金制。使用した分だけ支払い。ヘビーユーザーとチーム向けにボリュームディスカウントあり。
各アカウントにはベースラインレート制限があります。通常の使用は体験に影響しません。より高い同時実行プランが利用可能。
複雑なセットアップは不要。テキストプロンプトで画像を生成。経験豊富なユーザー向けの高度なコントロールはオプション。
はい。生成されたコンテンツは商用利用可能。製品ビジュアル、広告、ブランドアセットを含みます。適用されるコンテンツと著作権ルールに従ってください。
優れた多言語テキストレンダリングと正確なタイポグラフィ。ポスター、タイトル、ラベル、インフォグラフィックに最適。
はい。強力なキャラクターとスタイルの一貫性をサポート。ブランドIP、コミックキャラクター、バーチャルモデルに最適。
ユーザーフィードバック
FireRed Image Editに対するユーザーの評価
“FireRed Image Editはワークフローを簡素化しました。迅速かつ一貫してプロフェッショナルなビジュアルを生成できます。”
田中優子: “FireRed Image Editはワークフローを簡素化しました。迅速かつ一貫してプロフェッショナルなビジュアルを生成できます。”
佐藤健太: “キャラクター一貫性機能は優れています。ブランドコンテンツの作成に最適です。”
山田美咲: “シーン構成とライティングが素晴らしい。プロフェッショナル品質の結果です。”
鈴木大輔: “ライティングと被写界深度が自動処理されます。ポストプロダクション時間を大幅に節約。”
高橋由美: “製品画像の一括生成が効率的で正確。修正なしでアップロード可能。”
伊藤誠: “アセット間のスタイル一貫性が優れています。ブランドビジュアルアイデンティティに最適。”
渡辺翔太: “構図の理解力が印象的です。シーンの意図を正確に捉えます。”
小林愛: “生地のテクスチャとディテールがリアルに見えます。ファッションコンテンツに最適。”