カメラワーク
クリックして再生
動的なカメラワーク
トラッキング、オービット、快速シーン転換 — AIがカメラ路線を自動計画、滑らかで映画的な画面を每秒提供。
AIモデルで動画を生成します。テキストから動画、画像から動画、動画から動画をサポートします。
効果を推測しないでごらんください。実際の作品はすべてAI生成で、カメラワーク、モーション、特殊効果、音乐ビート同期の実力を展示。
快速アクション、极限スポーツ、複雑なインタラクション — AIが精密にアクショリズムと物理的ディテールを捉え、流畅で現実的な冲击的な画面を生成。
トラッキング、オービット、快速シーン転換 — AIがカメラ路線を自動計画、滑らかで映画的な画面を每秒提供。
人物の跑步跳躍、物体間衝突、環境インタラクション、アクショ、ロジック全程一貫保持、模型破りも不自然さもない。
動画をアップロードすればカメラワークを学習、音乐でビート同期、画像でスタイル設定。AIが参考資料を理解し、期待に副う動画を生成。
参考動画をアップロードすれば、AIがカメラブロッキングとアクショ、ロジックを学習、相同スタイルの新型動画を生成、チーム協力更高效。
鞭み切り、マッチカット、スタイル化揭示 - AIがトランジションリズムを学習、プロ级别的編集感がある動画批量生成。
頭の中の場面を描写すれば、AIがシーンを自動連携、アクションとナラティブリズムを補完、想法から完成まで最快数分。
音楽をアップロードすれば、AIがビートに合わせて画面切换とアクショ/リズムを制御、TikTokビート動画もCMも手動同期不要。
从多款 AI 视频模型中选择,支持文生视频、图生视频、视频转视频等多种生成模式。
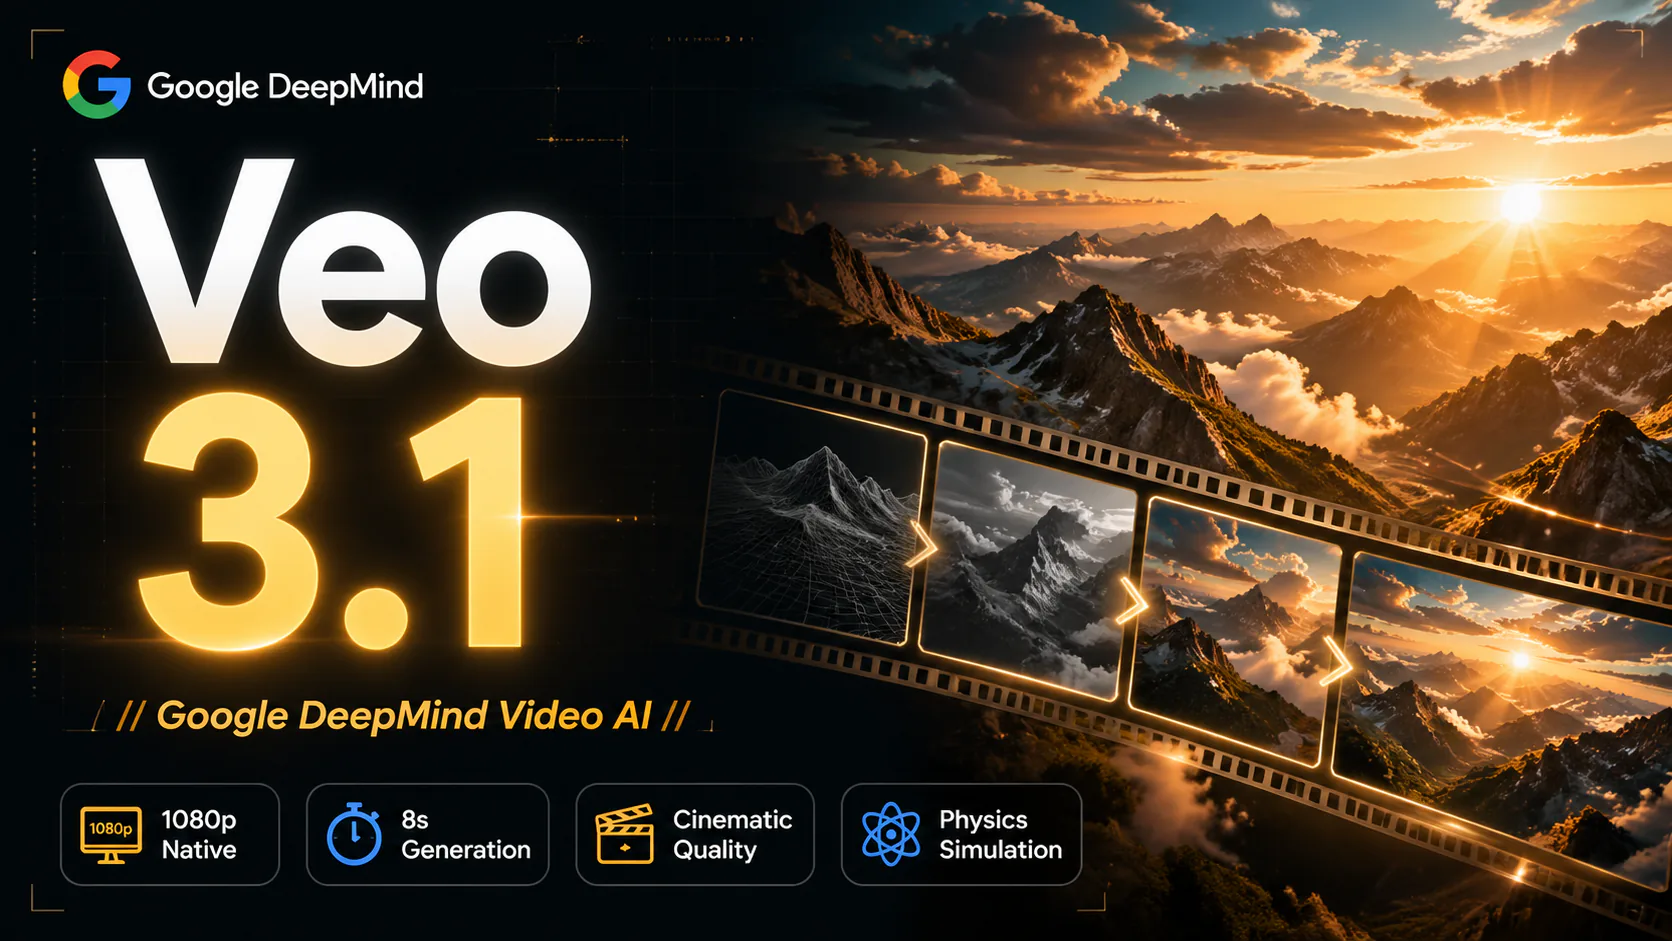
Googleの最新フラッグシップ動画生成モデル。Veo 3.1 Qualityは業界最高峰の物理エンジンと超高忠実度を備え、現実世界の質感、動き、細部を完璧に再現します。16:9、9:16、自動アスペクト比に対応し、商用高品質動画制作に最適です。
Soraシリーズの標準版。OpenAIの優れたプロンプト理解力を維持しつつ、速度とコストを最適化。絵コンテ、SNS動画、迅速なクリエイティブ制作に最適です。
HappyHorse はアリババの次世代マルチモーダル動画生成モデルで、音声と映像のネイティブな協調生成に対応。単一モデルでテキスト→動画、画像→動画、複数画像参照→動画、動画内インプレイス編集の 4 シーンをカバーし、広告・EC・ショートドラマ・SNS クリエイティブに最適です。
Wan 2.6は、テキストから動画、画像から動画、動画から動画の3つのモードをサポートする先進的な動画生成モデルです。5秒、10秒、15秒の長さオプションと720p、1080pの解像度を提供し、多様な動画コンテンツ作成に適したマルチショット機能を備えています。


Kling モーションコントロールモデルは、アップロードされた参照画像と動画を通じて、キャラクターの動きと姿勢を正確に制御します。3〜30秒の動画をサポートし、参照と一致したキャラクターアクションを生成でき、キャラクターアニメーションとモーション転送シナリオに最適です。
複雑な動きや物理法則の再現で有名です。Kling 2.6は、ダイナミックなキャラクターの動き、複雑な物体の相互作用、映画のようなカメラワークを滑らかに生成することに優れています。
ByteDanceの先進的な動画生成モデル。Seedance 1.5 Proは、精密なリップシンクと自然な表情を持つキャラクターアニメーションに優れています。リアルな動きの物理演算を備え、複数のアスペクト比(1:1、21:9、4:3、3:4、16:9、9:16)に対応し、柔軟な長さオプション(4秒、8秒、12秒)とオプションの音声生成を提供します。
ByteDanceの次世代動画生成モデル。Seedance 2 は高画質な映像、複雑な動き、そしてマルチモーダルな参照制御に重点を置いています。テキスト、画像、動画、音声入力をサポートし、より高い一貫性と豊かなカメラ表現が求められる本格的な映像制作に適しています。
Wan 3.0 Videoは、テキストから動画、画像から動画、参照から動画、画像・動画・音声を使った動画編集に対応するAlibabaのマルチモーダル動画モデルです。
Wan 3.0 Video Primeは、動きと構図をより細かく制御できる、高品質なテキスト・画像・参照から動画向けのWanモデルです。
ByteDanceの次世代動画生成モデル。テキストからの動画生成、始点・終点フレームによる画像から動画生成、画像・動画・音声を組み合わせた参照生成に対応し、480p/720p、4〜30秒、音声生成を利用できます。
Seedance 2 の高速かつ高コスト効率版。アイデアの高速反復、プロンプトの一括テスト、高頻度なコンテンツ制作に最適で、画像・動画・音声の参照入力も引き続きサポートします。
Lightweight Seedance 2 for lower-cost drafts with first/last frames and multimodal references.
xAI が提供するクリエイティブな動画生成モデル。Grok Imagine はテキスト記述を想像力豊かな動画コンテンツに変換することに優れており、複数のアスペクト比(2:3、3:2、1:1、9:16、16:9)をサポートし、fun、normal、spicy の3つのスタイルモードを提供します。クリエイティブコンテンツ制作と迅速なプロトタイピングに最適です。
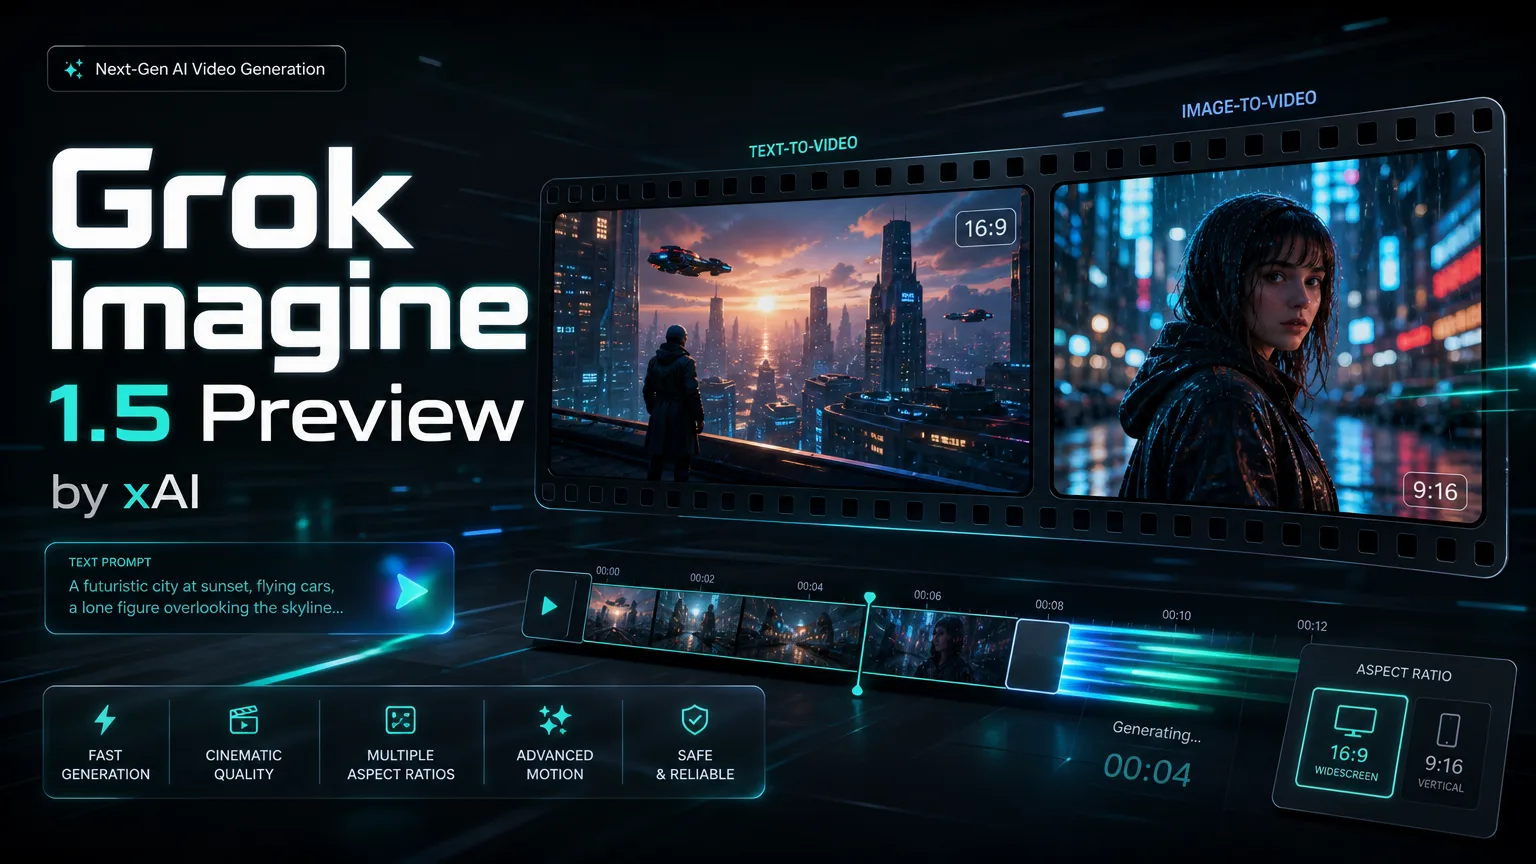
Grok Imagine Video 1.5 Preview is an image-to-video model. It requires one reference image, outputs fixed 720P video, supports 5-15 second durations, and supports 16:9, 9:16, 3:2, 2:3, 1:1, 3:4 and 4:3 aspect ratios.
Gemini OmniはGoogleのOmni-Flash-Extベースの先進的な動画生成モデルです。テキストから動画、画像から動画、3枚の参照画像融合に対応。4/6/8/10秒の長さと16:9、9:16のアスペクト比をサポートします。
Gemini Omni 1.1 Flashは、テキストから動画、画像から動画、参照画像に対応し、柔軟な長さと複数のアスペクト比を提供するGoogleのマルチモーダル動画モデルです。
MiniMax H3は、テキスト・画像・参照から動画を生成できるマルチモーダルモデルで、768p/2K出力、柔軟な長さ、参照音声に対応します。
MiniMax H3 Maxは、480p/768pのテキスト動画生成と開始・終了フレームによる画像動画生成に対応する高速モデルで、5〜15秒を出力します。
MiniMax H3 Max Turboは、480p/768pのテキスト動画生成と、開始フレーム必須・終了フレーム任意の画像動画生成に対応する低コスト高速版です。
テキストまたは1枚の画像から1〜15秒の動画を作成。最大1080pで、音声の同時生成も選べます。
PixVerse V6 は、テキストからの動画生成、画像アニメーション、始点・終点フレームのトランジション、動画延長に対応する柔軟なモデルです。360p〜1080p、1〜15秒、ネイティブ音声を選べます。
1枚の開始画像を動画にするか、最大15枚の参照画像を使います。540p~4K、画像モードは3~16秒、参照モードは1~16秒。同期音声は任意です。参照音声は3~12秒のMP3を使用してください。
テキスト、画像、参考資料を入力すると、AIが自動的に高品質な動画を生成。編集経験も、高価な機材も不要。数分で Videos が完成。
説明を入力するか、画像を一枚アップロードすれば、AIがそのまま動画を生成。広告素材からSNS投稿まで、このプラットフォームで全部対応。
カメラ移動、シーン転換、テンポコントロール、AIが自動処理。望みの効果を説明するだけで、プロ级别的画質を提供。
複数のシーンを自動的に連携させ、ドラマ性のある完全な短編動画を生成。ブランドストーリー、商品紹介、クリエイティブ絵コンテをそのまま的作品に。
音楽を一曲アップロードすれば、AIがビートに合わせて画面切り替えを自動調整。TikTokバズ動画やCMも手動での同期は不要です。
ブラウザを開けばどこでも動画生成可能。スマホ、タブレット、PC全対応。移動時間でも効率的に作品作り。
画像をアップロードすればスタイル指定、動画でカメラワーク指定、音乐でリズム指定。何を参考にするかがそのまま出力に。
FireRed Image Editに関するよくある質問
FireRed Image Editは高品質な画像、ポスター、キャラクターデザイン、製品モックアップ、インフォグラフィックを生成できます。シーンの一貫性、ライティングシミュレーション、スタイル保持をサポート。
ネイティブ2K解像度、4Kアップスケーリング、インペインティング、キャラクター一貫性、テキストレンダリング、マルチスタイル切り替え、高忠実度出力。
柔軟な従量課金制。使用した分だけ支払い。ヘビーユーザーとチーム向けにボリュームディスカウントあり。
各アカウントにはベースラインレート制限があります。通常の使用は体験に影響しません。より高い同時実行プランが利用可能。
複雑なセットアップは不要。テキストプロンプトで画像を生成。経験豊富なユーザー向けの高度なコントロールはオプション。
はい。生成されたコンテンツは商用利用可能。製品ビジュアル、広告、ブランドアセットを含みます。適用されるコンテンツと著作権ルールに従ってください。
優れた多言語テキストレンダリングと正確なタイポグラフィ。ポスター、タイトル、ラベル、インフォグラフィックに最適。
はい。強力なキャラクターとスタイルの一貫性をサポート。ブランドIP、コミックキャラクター、バーチャルモデルに最適。
FireRed Image Editに対するユーザーの評価
“FireRed Image Editはワークフローを簡素化しました。迅速かつ一貫してプロフェッショナルなビジュアルを生成できます。”
田中優子: “FireRed Image Editはワークフローを簡素化しました。迅速かつ一貫してプロフェッショナルなビジュアルを生成できます。”
佐藤健太: “キャラクター一貫性機能は優れています。ブランドコンテンツの作成に最適です。”
山田美咲: “シーン構成とライティングが素晴らしい。プロフェッショナル品質の結果です。”
鈴木大輔: “ライティングと被写界深度が自動処理されます。ポストプロダクション時間を大幅に節約。”
高橋由美: “製品画像の一括生成が効率的で正確。修正なしでアップロード可能。”
伊藤誠: “アセット間のスタイル一貫性が優れています。ブランドビジュアルアイデンティティに最適。”
渡辺翔太: “構図の理解力が印象的です。シーンの意図を正確に捉えます。”
小林愛: “生地のテクスチャとディテールがリアルに見えます。ファッションコンテンツに最適。”