Gemini Omni
Googles multimodales Erstellungsmodell — wo Geminis Denkfähigkeit auf kreative Gestaltung trifft. Erstelle und bearbeite Videos aus Text, Bildern, Video oder Audio mit natürlicher Sprache. Jede Bearbeitung baut auf der vorherigen auf. Kostenlos testen mit FireRed Image Edit .
Über Gemini Omni
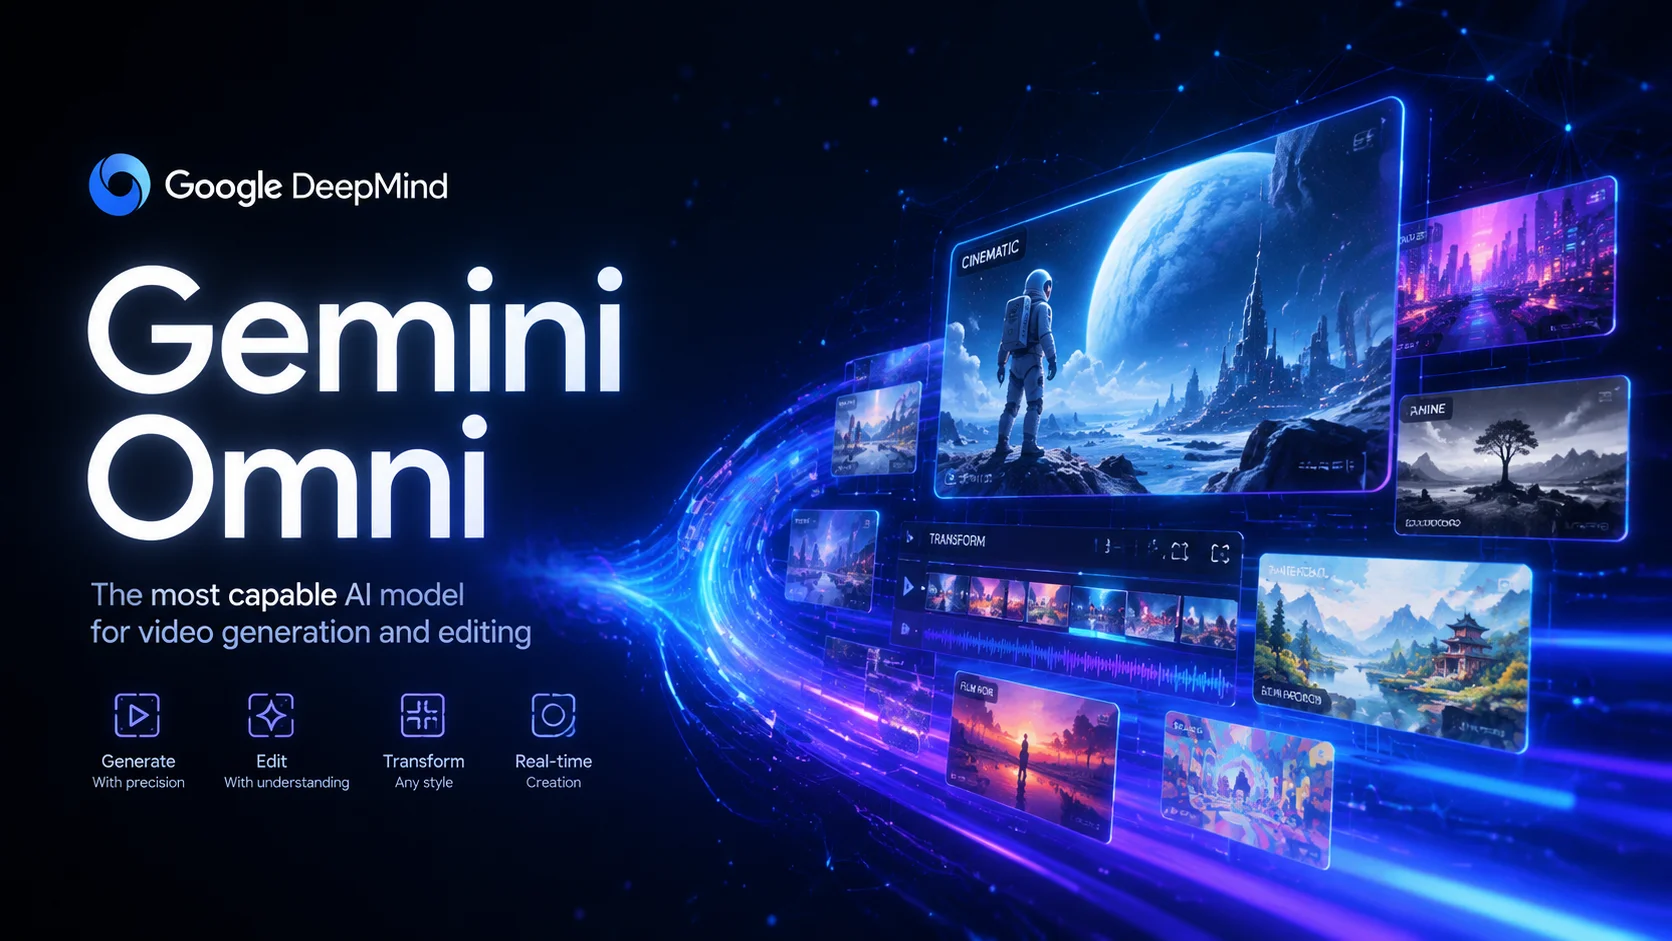
Gemini Omni ist das multimodale Erstellungsmodell von Google DeepMind, vorgestellt auf der Google I/O 2025. Es vereint Geminis Denkfähigkeit mit generativen Mediensystemen und ermöglicht Videogenerierung und -bearbeitung, die über einfache Prompt-zu-Video-Ausgabe hinausgeht. Das Modell versteht Szenen, Handlungen, Umgebungen, physikalisches Verhalten und realen Kontext — und liefert Ergebnisse, die gezielt wirken statt zufällig. Gemini Omni Flash ist das erste Modell der Omni-Familie, entwickelt für praktische Workflows zur Videoerstellung und -bearbeitung, bei denen Nutzer Filmmaterial transformieren, Ergebnisse mit Referenzen steuern und Szenen durch natürliche Sprachkonversation verfeinern können.
Kernfunktionen
Multimodaler Input, konversationelle Bearbeitung, Stiltransformation und Weltwissen — alles in einem Modell
Core Features Overview
Mehrstufige konversationelle Bearbeitung
Gemini Omni führt einen grundlegend anderen Ansatz zur Videobearbeitung ein. Anstatt bei jeder Generierung von vorne zu beginnen, kannst du dein Video durch eine Reihe natürlichsprachlicher Anweisungen verfeinern. Ändere den Hintergrund, passe die Handlung an, ersetze Objekte, verschiebe den Kamerawinkel oder füge visuelle Effekte hinzu — alles bei gleichzeitiger Stabilität des restlichen Videos. Dieser konversationelle Workflow bedeutet, dass du Schritt für Schritt auf deine Vision hinarbeiten kannst, ähnlich wie beim Bearbeiten eines Dokuments mit nachverfolgten Änderungen.
Bearbeite in mehreren Schritten: Zuerst die Szene aufbauen, dann den Kamerawinkel ändern, dann atmosphärische Effekte hinzufügen — durchgehend Konsistenz bewahren
Mehrstufige Bearbeitung bewahrt die Szenenkohärenz über sequenzielle Änderungen hinweg
Zuerst eine Person in einem Raum etablieren, dann die Beleuchtung auf goldene Stunde ändern, dann Regen am Fenster hinzufügen — jede Bearbeitung baut auf der letzten auf
Sequenzielle Umgebungsänderungen demonstrieren konversationelle Verfeinerung
Echtzeit-Stiltransformation
Gemini Omni kann den visuellen Stil jedes Eingabevideos transformieren und dabei die zugrundeliegende Bewegung, Struktur und Szenenkomposition bewahren. Beschreibe die gewünschte Ästhetik — metallische Oberflächen, handgezeichnete Skizzen, Filzpuppen, holografische Projektionen, Voxel-Kunst — und das Modell wendet die Transformation kohärent auf jeden Frame an. Die ursprüngliche Kamerabewegung, Charakterhandlungen und räumlichen Beziehungen bleiben intakt, was einen nahtlosen Stiltransfer erzeugt, der weit über einfache Filter hinausgeht.
Wenn die Person den Spiegel berührt, soll der Spiegel wunderschön wie Flüssigkeit wellen, und der Arm der Person verwandelt sich in reflektierendes Spiegelmaterial
Stiltransformation bewahrt die Bewegung bei vollständiger Änderung der visuellen Ästhetik
Wenn die Person den Spiegel berührt, verwandelt sich die gesamte Umgebung in 3D-Voxel-Kunst mit blockigen geometrischen Formen
Vollständige Umgebungstransformation in Voxel-Kunst bei Bewahrung der räumlichen Struktur
Echter multimodaler Input
Im Gegensatz zu Modellen, die nur Text oder ein einzelnes Bild akzeptieren, kann Gemini Omni mehrere Eingabetypen gleichzeitig verarbeiten. Gib Text für die Richtung, Bilder als visuelle Referenz, Video für Bewegungsführung und Audio für Sprach- oder Klangsynchronisation an. Das Modell synthetisiert alle Eingaben zu einer einzigen zusammenhängenden Videoausgabe. Das macht es praktisch für reale kreative Workflows, bei denen Inspiration aus mehreren Quellen kommt — eine Storyboard-Skizze, ein Referenzclip, eine Sprachaufnahme und eine schriftliche Beschreibung können alle zum Endergebnis beitragen.
Füge Harfenklänge hinzu, die synchron erklingen, wenn ich jedes Farnblatt berühre. Verwandle die Blattstruktur in biolumineszente Pflanzen mit umherfliegenden Glühwürmchen
Kombination von Videoeingabe mit Textanweisungen und Audioreferenz für synchronisierte Ausgabe
Visualisiere den Proteinfaltungsprozess mit realem wissenschaftlichem Wissen, gerendert im Knetanimationsstil mit genauem molekularem Verhalten
Reales Wissen angewandt auf wissenschaftliche Visualisierung mit kreativem Stil
Häufig gestellte Fragen
Gemini Omni FAQ
Gemini Omni ist das multimodale Erstellungsmodell von Google DeepMind, das Geminis Denkfähigkeit mit Videogenerierung kombiniert. Im Gegensatz zu herkömmlichen Text-zu-Video-Modellen unterstützt Gemini Omni mehrstufige konversationelle Bearbeitung (jede Bearbeitung baut auf der vorherigen auf), akzeptiert mehrere Eingabetypen gleichzeitig (Text, Bilder, Video, Audio) und wendet Weltwissen an, um kontextuell bedeutungsvolle Ergebnisse zu erzielen.
Gemini Omni akzeptiert Textprompts, bis zu 7 Referenzbilder, 1 Videoclip (bis zu 100 MB, 30 Sekunden) und Audio-IDs. Du kannst mehrere Eingabetypen in einer einzigen Generierung kombinieren — zum Beispiel ein Referenzvideo plus Textanweisungen, um die Szene zu transformieren und dabei die ursprüngliche Bewegung beizubehalten.
Ja. FireRed Image Edit bietet Credits zur Videogenerierung mit Gemini Omni. Neue Nutzer erhalten kostenlose Credits, um sofort loslegen zu können. Das Modell unterstützt Dauern von 4/6/8/10 Sekunden mit Seitenverhältnissen von 16:9 und 9:16.
Ja. Gemini Omni eignet sich hervorragend für Videobearbeitung durch natürliche Sprache. Lade ein Quellvideo hoch und beschreibe, was du ändern möchtest — transformiere die Umgebung, ersetze Objekte, ändere den Stil, passe die Kameraperspektive an oder füge Effekte hinzu. Das Modell bewahrt Elemente, die du nicht erwähnst, während es deine gewünschten Änderungen anwendet.
Videoeingabedateien müssen unter 100 MB groß und nicht länger als 30 Sekunden sein. Der nutzbare Trimmbereich (Start bis Ende) darf 10 Sekunden nicht überschreiten. Bilddateien müssen jeweils unter 20 MB sein, mit maximal 7 Bildern pro Generierung. Generierte Videos können 4, 6, 8 oder 10 Sekunden lang sein.
Mehrstufige Bearbeitung bedeutet, dass jede Generierung auf dem vorherigen Ergebnis aufbauen kann. Du beginnst mit einer ersten Erstellung und verfeinerst sie dann durch Folgeanweisungen — ändere den Winkel, füge Effekte hinzu, modifiziere die Handlung, passe die Beleuchtung an — während das Modell die Konsistenz mit dem Vorherigen bewahrt. Das ist vergleichbar mit dem Bearbeiten eines Dokuments durch mehrere Überarbeitungen.
Ja. Über FireRed Image Edit generierte Videos beinhalten kommerzielle Nutzungsrechte. Gemini Omni ist für kommerzielle Nutzung lizenziert und eignet sich damit für Marketinginhalte, Social Media, Produktpräsentationen, Lehrmaterialien und professionelle Videoproduktion.
Was Creator über Gemini Omni sagen
“Die mehrstufige Bearbeitung hebt Gemini Omni von anderen ab. Ich kann eine Szene Schritt für Schritt verfeinern, anstatt jedes Mal von vorne zu generieren. Es fühlt sich tatsächlich wie Regie führen an, nicht wie Prompting.”
Elena Vasquez: “Die mehrstufige Bearbeitung hebt Gemini Omni von anderen ab. Ich kann eine Szene Schritt für Schritt verfeinern, anstatt jedes Mal von vorne zu generieren. Es fühlt sich tatsächlich wie Regie führen an, nicht wie Prompting.”
Takeshi Mori: “Die Möglichkeit, Videostile zu transformieren und dabei die ursprüngliche Bewegung beizubehalten, ist unglaublich nützlich für Konzeptarbeit. Die Metall- und Hologramm-Transformationen sind besonders beeindruckend.”
David Chen: “Gemini Omni versteht Kontext auf eine Weise, die andere Modelle nicht können. Wenn ich nach einer wissenschaftlichen Visualisierung frage, stimmt die Physik tatsächlich, anstatt nur vage wissenschaftlich auszusehen.”
Weitere KI-Video-Modelle entdecken


Starte jetzt mit Gemini Omni
Erlebe die Leistungsfähigkeit von Gemini Omni — kostenlos online
10,000+ users