FireRed Image Edit
  • ホーム
  • レビュー
  • 素材
  • クーポン
  • 料金
モデル
FireRed Image EditGrok 4.2 ImageFLUX.2 Klein 9BNano BananaGLM ImageNano Banana 2Nano Banana 2.1Nano Banana 2 LiteNano Banana ProSeedream 5.0 LiteSeedream 5.0 FlashSeedream 5.0 ProGPT-Image 1.5GPT Image 2GPT Image 2.5GPT Image 2.5 FlareGPT Image 2.5 SunburstSeedream 4.5FLUX.2FLUX 3 KleinZ-ImageGrok Imagine Image 2Qwen Image 3Veo 3.1Sora 2HappyHorseWan 2.6Kling 3.0Kling 3.0 OmniKling 4.0Kling 3.0 Motion ControlKling モーションコントロールKling 2.6Seedance 1.5 ProSeedance 2Wan 3.0 VideoWan 3.0 Video PrimeSeedance 2.5Seedance 2 FastSeedance 2 MiniGrok ImagineGrok Imagine Video 1.5 PreviewGrok Imagine Video 1.5 LiteGemini OmniGemini Omni 1.1 FlashMiniMax H3MiniMax H3 MaxMiniMax H3 Max TurboPixVerse V6 MaxPixVerse V6Vidu Q4
FireRed Image EditFireRed Image Edit

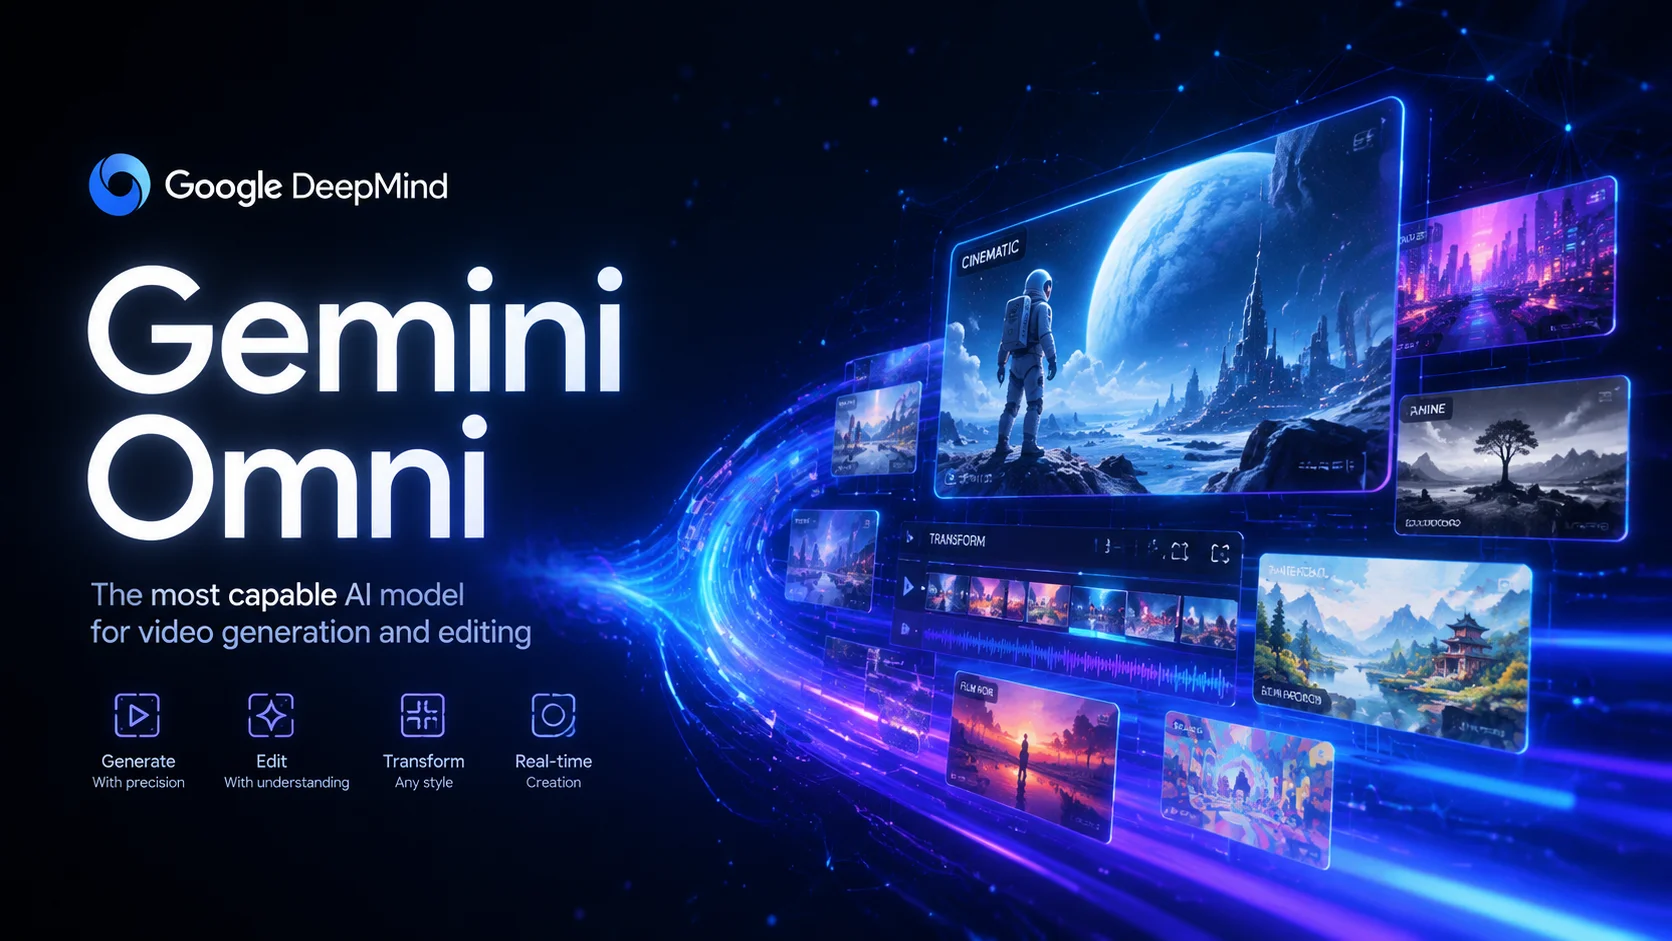
Gemini Omni

Googleのマルチモーダル創作モデル — Geminiの推論能力と生成メディアシステムの融合。テキスト、画像、動画、音声から自然言語で動画を生成・編集し、各編集は前回の結果に基づいて構築されます。 FireRed Image Edit で無料体験。
Gemini Omni
  1. ホーム
  2. /
  3. AI動画生成器
  4. /
  5. Gemini Omni
About

Gemini Omniについて

Gemini Omniは、Google DeepMindが2025年のGoogle I/Oで発表したマルチモーダル創作モデルです。Geminiの推論能力と生成メディアシステムを組み合わせ、単純なプロンプトから動画を生成する以上の能力を実現します。シーン、アクション、環境、物理的挙動、実世界のコンテキストを理解し、ランダムではなく意図的な結果を生成します。Gemini Omni Flashは実用的な動画制作・編集ワークフロー向けに構築され、ユーザーは素材を変換し、参照で結果を導き、自然言語の会話でシーンを洗練できます。

Gemini Omniについて

主要機能

マルチモーダル入力、会話型編集、スタイル変換、実世界の知識 — すべてを一つのモデルで

Core Features Overview

マルチターン会話型編集

Gemini Omniは動画編集に根本的に異なるアプローチを導入します。毎回ゼロから生成する代わりに、一連の自然言語指示で動画を洗練できます。背景の変更、アクションの調整、オブジェクトの置換、カメラアングルの変更、視覚効果の追加 — すべて動画の残りの部分を安定させたまま。

プロンプト
Output (Example)

マルチターン編集:まずシーンを確立し、次にカメラアングルを変更し、雰囲気効果を追加 — 全体を通して一貫性を維持

マルチターン編集は連続的な修正全体でシーンの一貫性を保持

您的浏览器不支持视频播放。

まず部屋にいる人物のシーンを確立し、次に照明をゴールデンアワーに変更し、窓に雨を追加する — 各編集は前回に基づく

連続的な環境変更が会話型の段階的改善を実証

您的浏览器不支持视频播放。

リアルタイムスタイル変換

Gemini Omniは入力動画の視覚スタイルを変換しながら、基礎となる動き、構造、シーン構成を保持できます。ターゲットの美学を記述すれば、モデルが各フレームに一貫して変換を適用します。

プロンプト
Output (Example)

人が鏡に触れると、鏡が液体のように美しく波打ち、人の腕が反射するミラー素材に変わる

スタイル変換は視覚的美学を完全に変えながら動きを保持

您的浏览器不支持视频播放。

人が鏡に触れると、環境全体がブロック状の幾何学的形状を持つ3Dボクセルアートに変換される

空間構造を保持しながらボクセルアートへの完全な環境変換

您的浏览器不支持视频播放。

真のマルチモーダル入力

テキストや単一画像のみを受け入れるモデルとは異なり、Gemini Omniは複数の入力タイプを同時に処理できます。テキストで方向性、画像で視覚参照、動画でモーションガイダンス、音声で音声同期を提供。モデルがすべての入力を一つの統一された動画出力に統合します。

プロンプト
Output (Example)

シダの葉に触れるたびにハープの音を追加。葉の構造を生物発光植物に変え、蛍が飛び回る

動画入力、テキスト指示、音声参照を組み合わせて同期出力を実現

您的浏览器不支持视频播放。

実世界の科学知識を使用してタンパク質折りたたみプロセスを可視化し、正確な分子挙動をクレイアニメーションスタイルでレンダリング

実世界の知識を科学的可視化に適用し、クリエイティブなスタイルと組み合わせ

您的浏览器不支持视频播放。
FAQ

よくある質問

Gemini Omni FAQ

01

Gemini OmniはGoogle DeepMindのマルチモーダル創作モデルで、Geminiの推論能力と動画生成を組み合わせています。従来のテキストから動画モデルとは異なり、マルチターン会話型編集、複数入力タイプの同時受け入れ、実世界の知識の活用をサポートします。

02

テキストプロンプト、最大7枚の参照画像、1つの動画クリップ(最大100MB、30秒)、音声IDを受け入れます。単一の生成で複数の入力タイプを組み合わせることができます。

03

はい。FireRed Image EditはGemini Omniで動画を生成するためのクレジットを提供しています。新規ユーザーは無料クレジットですぐに創作を開始できます。4/6/8/10秒の長さ、16:9と9:16のアスペクト比をサポート。

04

はい。Gemini Omniは自然言語による動画編集に優れています。ソース動画をアップロードし、変更したい内容を記述してください — 環境の変換、オブジェクトの置換、スタイルの変更、カメラ視点の調整、エフェクトの追加が可能です。

05

動画入力ファイルは100MB以下、30秒以内である必要があります。使用可能なトリム範囲は10秒を超えることはできません。画像ファイルは各20MB以下、生成あたり最大7枚。生成される動画は4、6、8、10秒です。

06

マルチターン編集では、各生成が前回の結果に基づいて構築されます。初期の創作から始め、フォローアップの指示で洗練 — アングルの変更、エフェクトの追加、アクションの修正、照明の調整 — モデルが前回との一貫性を維持します。

07

はい。FireRed Image Editを通じて生成された動画には商用利用権が付属しています。マーケティングコンテンツ、ソーシャルメディア、製品ショーケース、教育資料、プロの動画制作に適しています。

Testimonials

クリエイターのGemini Omniへの評価

“マルチターン編集がGemini Omniを際立たせています。毎回ゼロから再生成する代わりに、シーンを段階的に洗練できます。プロンプトを書くのではなく、本当に演出している感覚です。”

E

Elena Vasquez

クリエイティブディレクター

Elena Vasquez: “マルチターン編集がGemini Omniを際立たせています。毎回ゼロから再生成する代わりに、シーンを段階的に洗練できます。プロンプトを書くのではなく、本当に演出している感覚です。”

Takeshi Mori: “元の動きを保持しながら動画スタイルを変換できるのは、コンセプトワークに非常に便利です。メタルとホログラムの変換は特に印象的です。”

David Chen: “Gemini Omniは他のモデルにはないコンテキスト理解力があります。科学的可視化を求めると、漠然と科学的に見えるものではなく、実際に物理を正しく表現します。”

他のAI動画モデルを探索

Veo 3.1 無料AI動画生成ツール

Veo 3.1 無料AI動画生成ツール

新着

Veo 3.1はGoogle DeepMindの最先端無料AI動画生成ツールで、革新的なネイティブ音声生成機能を搭載。オンラインで1080p HD動画を無料生成し、効果音・対話・環境音を同期作成。透かしなし、無制限。クリップあたり最大8秒、60秒以上に拡張可能、24FPS出力。

今すぐ試す
Sora 2

Sora 2

Sora 2はOpenAIのフラッグシップ動画生成モデルで、テキスト記述と画像入力の両方から高品質な動画を生成できます。複雑なシーン構成、キャラクターの相互作用、カメラワーク、現実世界の物理法則を理解し、映画級の結果を提供します。Sora 2はAI動画生成における大きな飛躍であり、時間的一貫性の向上、より長い尺のサポート、より忠実なプロンプト解釈を実現しています。

今すぐ試す
HappyHorse

HappyHorse

新着

HappyHorse はアリババの次世代AI動画モデルで、ネイティブなマルチモーダルアーキテクチャに基づいて構築されています。単一の統一モデルで4つの本番シーン(テキスト→動画、画像→動画、マルチ画像参照→動画、インプレイス動画編集)に対応し、ネイティブな音声・映像の共同合成、720p/1080p 出力を備え、広告、EC、ショートドラマ、SNS クリエイティブ制作に深く最適化されています。

今すぐ試す
Wan 2.6

Wan 2.6

新着

Wan 2.6はアリババの動画生成モデルで、テキストプロンプトと参考画像から多様なスタイル、滑らかなモーション、映画級の出力で高品質な動画を生成します。

今すぐ試す
Kling 4.0でイメージを映像の下書きに

Kling 4.0でイメージを映像の下書きに

新着

Kling 4.0は、文章、開始画像と任意の終了画像、または画像・動画の参照をもとに新しい映像を生成するモデルです。FireRedではKIE経由で3〜30秒、720pまたは1080pを指定できます。商品の見せ方や人物の動き、カメラワークを下書きで検討し、必要な部分を編集工程へ渡す用途に向いています。参照動画をそのまま書き換える操作とは異なります。

今すぐ試す
Kling 2.6

Kling 2.6

Kling 2.6は快手(Kuaishou)の最新AI動画生成モデルで、卓越なモーション品質と映画級の出力で知られています。先進的な時空モデリング技術に基づき、流れるようなキャラクターの動き、ダイナミックなカメラ遷移、豊かなビジュアルディテールを持つ動画を生成します。テキストから動画、画像から動画の両方をサポートし、プロ品質のAI動画コンテンツを求めるクリエイターにとって多用途なツールです。

今すぐ試す

Gemini Omniで創作を始めよう

Gemini Omniのパワーを体験 — 無料オンライン

今すぐ試す — 無料
user 1
user 2
user 3
user 4
user 5

10,000+ users

FireRed Image EditFireRed Image Edit

FireRed Image EditはAI画像生成プラットフォームで、プロフェッショナル品質の出力のための先進モデルへのアクセスを提供。

AI画像生成

  • GPT-Image 2
  • Seedream 5.0
  • Nano Banana 2
  • Grok 4.2 Image
  • Nano Banana Pro

AI動画生成

  • Gemini Omni
  • HappyHorse
  • Seedance 2
  • Veo 3.1
  • Grok Imagine 1.5
  • Wan 2.6

AIツール

  • 背景削除
  • 画像アップスケーラー
  • 写真修復
  • AI背景変更
  • AIオブジェクト削除
  • AI商品写真生成

動画エフェクト

  • AIハグ動画
  • AIキス動画
  • AIダンス動画
  • 地球ズームアウト
  • バレットタイム動画
  • 商品360°動画

探索

  • ショーケース
  • ブログ
  • 料金
  • API
  • 変更履歴
  • 私たちについて
© 2026 FireRed Image Edit· 無断転載を禁じます
プライバシーポリシー利用規約返金ポリシー返金申請私たちについて
DeutschEnglishEspañolFrançais繁體中文日本語한국어Türkçe中文עבריתPolski
ホームAI ツール素材プロフィール